OpenClaw 升级后报错、告警、变慢?五个问题的排查与处理
9.6 发布后,我把 GitHub 上评论最多的几条 issue 翻出来,对照自己 9.4 升 9.6 的环境逐个排查。下面五个问题都附了排查命令和判断标准,每节结尾都写了「什么时候不用管」——升级后大部分告警属于后者。
一、插件升级报 runtime application failed
症状:openclaw plugins update <id> 报 Plugin updates were saved but runtime application failed,接着 plugins reload 报 not tracked package install,点几次都没反应。社区 Update failure 开头的 issue 在 9.4/9.5/9.6 各有数条。
判断:先跑 openclaw plugins list。如果版本号已经是新版、状态 enabled,说明磁盘上的插件已经换新,只是运行时没跟上——这是升级期的加载毛刺,不是升级失败。
处理:重启容器,不要反复 reload。reload 本身就在报错,继续点没意义;重启后 plugins list 确认版本与状态即可。
不用管的情况:重启后版本对齐、状态正常,之前那条报错就是历史记录,不影响运行。
二、日志刷 memory pressure 告警
症状:日志每几分钟出一条 memory pressure: level=warning reason=rss_threshold,看着像内存泄漏。
先看 level,这决定要不要动手:
level=warning(RSS 1.5–3 GiB):只写日志,不执行任何动作;level=critical(RSS > 3 GiB):才会回收空闲 worker,到这档才需要处理。
再看走势,不看单点:
grep -o 'rss=[0-9.]* GiB' /tmp/openclaw/openclaw-$(date +%F).log | uniq
数值来回波动、每小时回落,说明是围绕阈值震荡,不是泄漏;单调上涨、几小时翻倍,才是社区 #154812 那类问题,按该 issue 的 workaround 处理(加 swap、设 cgroup 上限)。
阈值是怎么来的(源码 resolveThresholds):基础值 DEFAULT_RSS_WARNING_BYTES = 1536 MB,配置文件里没有对应配置项;给网关配了 --max-old-space-size 之后,阈值会按堆上限的比例抬高。稳态 RSS 由 V8 堆 + worker 堆 + native 开销构成,我实测在 1.5–1.6 GiB,刚好压在 1.5 GiB 这条线上,所以每 5 分钟采样必然破一次——这是阈值贴着稳态,不是泄漏。
处理:warning 档不用管。真要让日志清净,给 docker-compose 的网关 command 加 --max-old-space-size=2048,阈值随之抬高,代价是改配置加重启。
不用管的情况:只要还是 warning、走势不单调上涨,就放着。我全天 66 条告警,离 critical 还有约 1 GiB 余量,一次实际动作都没触发。
三、升级当天 ERROR 突然涨到几十条
症状:升级前日志 ERROR 为 0,升级当天几十条。
先分类,别急着当故障:
grep '"logLevelName":"ERROR"' /tmp/openclaw/openclaw-$(date +%F).log | \
  grep -oE 'No supported service manager|runtime application failed|prepared-model|lane task aborted|tool_call failed' | \
  sort | uniq -c
判断标准:
No supported service manager detected:容器部署没装 systemd,官方标注diagnostic only, not the probe target——提示信息,划掉;runtime application failed:第一节的问题,重启已解;prepared-model superseded:与 #157842 相关,9.6 的 catalog worker 定期重建代际,会作废正在执行的请求。偶发且任务最终执行成功,观察即可;某个任务稳定失败,才需要跟进;lane task aborted:任务被打断,下一轮会重跑,不用管。
处理:跑上面的分类命令,确认是哪类再决定。我这次 82 条里真正要动手的只有 6 条,重启后解决。
不用管的情况:分类后如果全是提示类和偶发类,数量再多也只是噪音。
四、升级后定时任务不跑(会话模型指向旧渠道)
症状:升级后一切正常,几天后发现某个定时任务没执行,或者模型调用报认证失败。
排查:
openclaw status
看 Model selection 段有没有会话的模型指向不在默认值上。我这次查出三个:一个定时任务钉在已停用的火山渠道,一个钉在即将下线的版本,主会话也是。
为什么会这样:升级/迁移时会话级的模型覆盖(session override)被保留成历史值,配置文件里的默认模型早就改了,两边不同步。
处理:通过 sessions 工具的 patch 动作逐个改回默认模型(openclaw sessions 命令行没有 patch 子命令)。
为什么必须查:这个问题平时不报错——主会话用着正常,定时任务要到下次运行才失败,可能过几天才发现。升完跑一次 openclaw status 是六步核查里最容易漏的一步。
不用管的情况:没有。这一项必须查,它不报错,漏了就是定时任务静默失败。
五、升级后感觉变慢了
判断方法:拿自己升级前的基线比,不要只看社区个案。
- 升级前 9.4:首响应中位数 3798ms
- 升级后 9.6:同口径中位数 3852ms,差距 1.4%,在正常波动内
自己测:
grep 'model-fetch] response' /tmp/openclaw/openclaw-$(date +%F).log | grep -oE 'elapsedMs=[0-9]+'
统计中位数,跟升级前的记录对比,差 10% 以内算正常。
顺带确认三个性能配置还在不在(这三项从 9.3 起就是性能关键,升级理论上不动,但值得扫一眼):sessionObserver: false、不配 cacheRetention、fastModeDefault: true。
不用管的情况:差距在 10% 以内、三个配置都在,就是正常波动,不用查社区个案。
升级完成后遇到异常,可以按下面的流程先判断该不该动手:
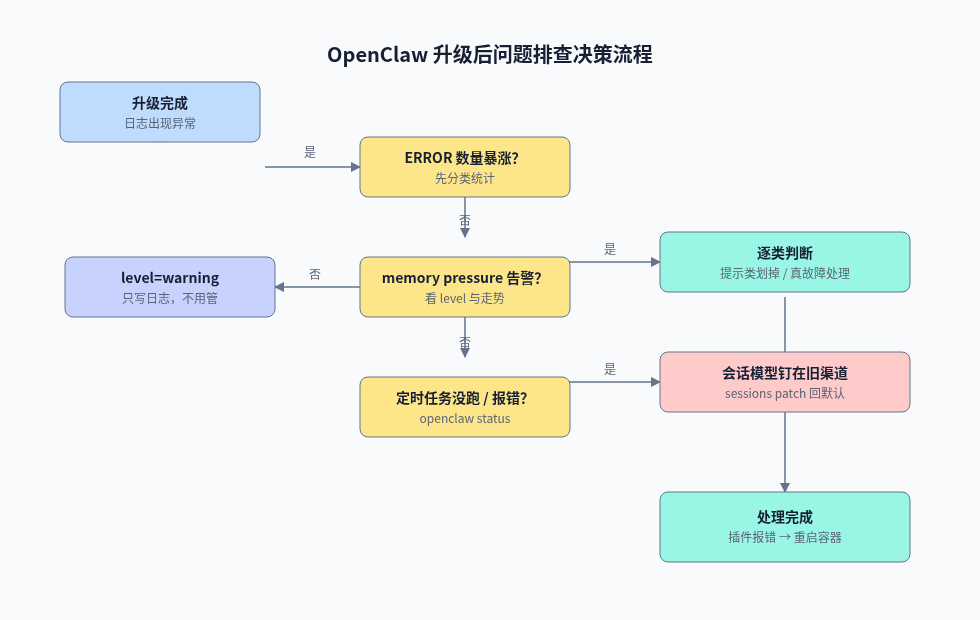
小结
| 症状 | 排查 | 处理 |
|---|---|---|
| 插件报 runtime application failed | openclaw plugins list 看版本是否已换新 | 重启容器,别反复 reload |
| memory pressure 刷屏 | 看是 warning 还是 critical、走势是否单向上涨 | warning 不用管;critical 或单向上涨才动手 |
| ERROR 涨到几十条 | 分类统计,看是提示还是真故障 | 提示划掉,真故障逐个处理 |
| 定时任务不跑 | openclaw status 查会话模型钉扎 | patch 回默认模型 |
| 变慢了 | 对比自己升级前的中位数基线 | 差 10% 内正常,超了再查三个性能配置 |
升级本身的风险主要在升级路径上,升完稳定运行后,真正影响体验的往往是这几件不查不知道的小事。社区的 issue 列表可以当检查参考,逐项对一遍,比等它出事再排查省事。