AI 出图第一课:底模是什么,SDXL 底模怎么选
刚开始用 ComfyUI 的人,多半卡在同一个困惑上:模型列表里几百个名字,SDXL、RealVisXL、Juggernaut、DreamShaper,它们到底是什么关系?随便选一个用行不行?
我一开始也是随便选,直到发现同样的提示词,换一个模型,出图质量天差地别。后来才明白一件事:换对底模一次,胜过改十次提示词。这篇把「底模」这个最基础的概念讲清楚。
底模是画家的功力
底模(Checkpoint)是一个几 GB 的模型文件,存着经过数十亿图文对训练出的神经网络权重。它相当于一位画家的功力:决定会不会画、擅长画什么、质量上限在哪。
一张图的生成流程并不复杂:提示词告诉底模画什么,采样器控制画多细,LoRA 和 ControlNet 是可选插件。底模坐在正中间,其余一切都围着它转。
打个比方:底模是画家本人,提示词是你下的订单,LoRA 是给画家加的风格滤镜,ControlNet 是让画家照着底稿描。功力不行,订单写得再好也白搭。
这解释了一个新手常见的误区:出图效果差,第一反应是改提示词。提示词只决定画什么,画质和画风的上限,从选定底模那一刻就已经锁定。
SDXL 和 RealVisXL 们是什么关系
SDXL 1.0 是 Stability AI 的官方原版,既定义了这一代模型的架构(1024 分辨率起步),也提供了原版权重。可以把 SDXL 理解成毛坯房:结构是好的,能住,但什么都不突出。
RealVisXL、Juggernaut XL、DreamShaper XL 这些社区模型,是作者拿 SDXL 当地基、用特定领域的图片继续训练出来的精装修版本:
- RealVisXL:专攻真实人像质感,头像写真的利器
- Juggernaut XL:全能写实,光影均衡,商品图和场景图的主力
- DreamShaper XL:多面手,写实、插画、2.5D 都能出,但样样通、样样松
它们的架构与 SDXL 完全相同,用法一样,SDXL 的 LoRA 大多通用。换底模只是换一个 checkpoint 文件,工作流一个节点都不用动;但等于换了一位画家,画风、质感、上限同时改变,比调任何参数的影响都大。
边界也要说清:SD 1.5 是上一代(512 分辨率时代),与 SDXL 的底模、LoRA、VAE 互不通用。直接从 SDXL 起步,不必在 SD1.5 上浪费时间。
我的选法:写实双雄
我的出图方向是电商商品图和人像写真,模型组合可以做减法:Juggernaut XL 当主力,全能写实,商品图场景图都能扛;RealVisXL 当备用,人像皮肤质感更专精,写真单子顶上。DreamShaper XL 这类多面手可以放弃——多面手的问题是没有长板,出的图容易往插画方向偏,撑不起交付级的写实需求。
多面手不是不好,是不匹配。以后接插画类单子,再补专门的风格模型也不迟。
下载渠道与四个坑
社区模型没有独立官网,作者本人在 CivitAI 上传的页面就是权威源头,HuggingFace 上的作者官方仓库同样可靠。除此之外的第三方下载站一律不碰:文件被篡改、缺 VAE、版本张冠李戴都是常事。
四条具体经验:
- 认准 fp16 版本(6.5GB 左右)。fp32 有 13GB,画质没有任何肉眼差别,纯浪费磁盘。顺带澄清一个概念:fp16 不是量化。量化是为内存不足的设备准备的压缩方案,有画质代价;SDXL 只有 6.5GB,完全用不着。
- 版本下拉框里优先选带 BakedVAE 的。VAE 已烘焙进文件,不用单独接 VAE 节点,也不会出灰图。
- 优先下 Lightning 版,4-8 步出图,速度是标准版的六倍以上。但必须配低参数:步数 4-8、CFG 1-2、采样器 DPM++ SDE Karras。拿普通参数跑 Lightning 版会出糊图,这是最常见的翻车点。标准版细节更足,留到交付精修时用。
- 验真看哈希。CivitAI 页面有模型哈希,ComfyUI 加载日志里也会显示,对得上就是正版。
两年前的模型,还值得学吗
RealVisXL V5.0 发布于 2024 年 9 月,到今天两年没大更新,SDXL 这一代生态整体进入「冻结但成熟」状态。纯论画质上限,FLUX 和国产新模型确实更强。
我依然从 SDXL 起步,理由有三:商用画质仍在付费水位线之上,Juggernaut 至今是下载量最大的 SDXL 精调版;ControlNet、LoRA、批量工具链全围绕 SDXL 建成,学习资料最全;对 Mac 这类统一内存设备,SDXL 是质量和速度的最佳平衡点。
更关键的是,工作流、参数、控图这套内功,八成可以迁移到任何新模型。先在成熟生态里把功力练成,真碰到画质天花板的那单,再上新模型不迟。
同 seed 实测:两个底模的画风差异
选型不能只听道理,上实测。我用同一套提示词、同一组 seed(666001 起递增)、同参数(6 步、CFG 1.0、768×1344),分别在两个底模上各出一批,直接看图。
seed 666001 的对照(左 RealVisXL,右 Juggernaut):
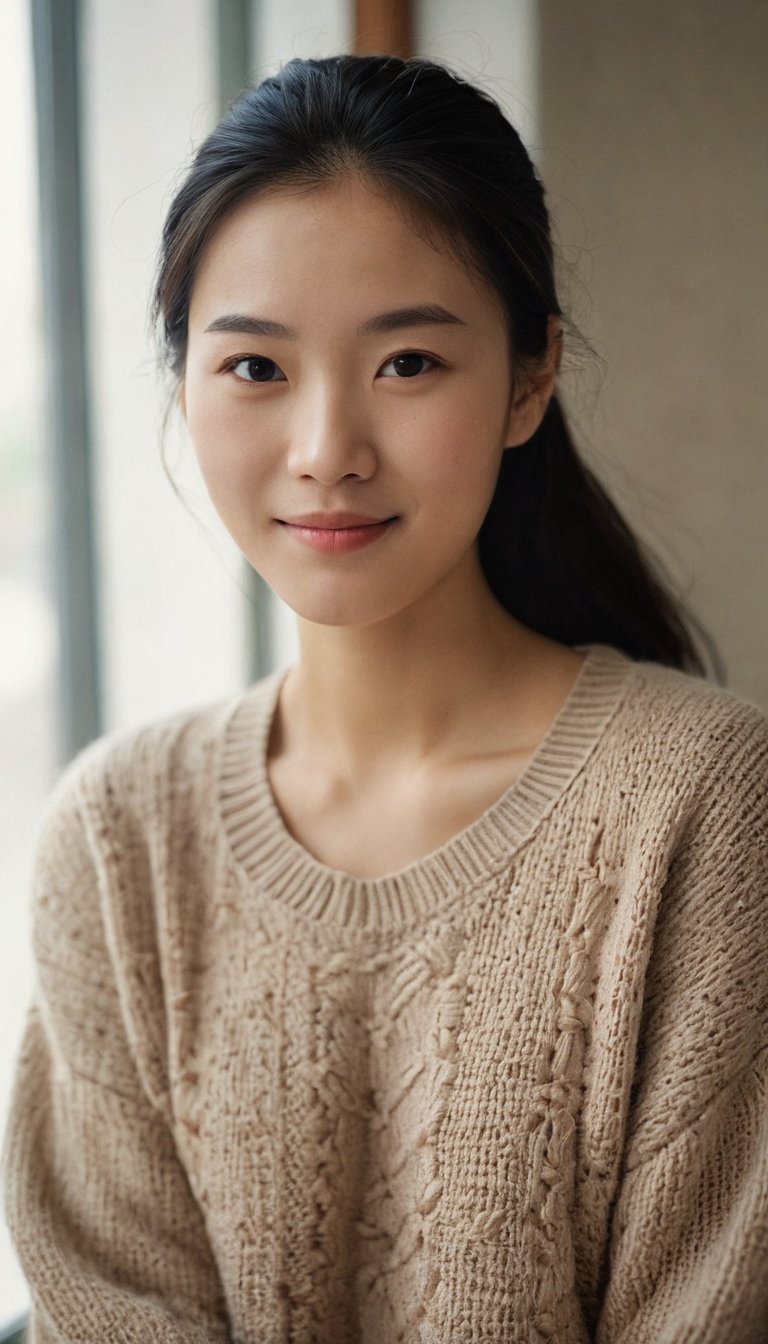
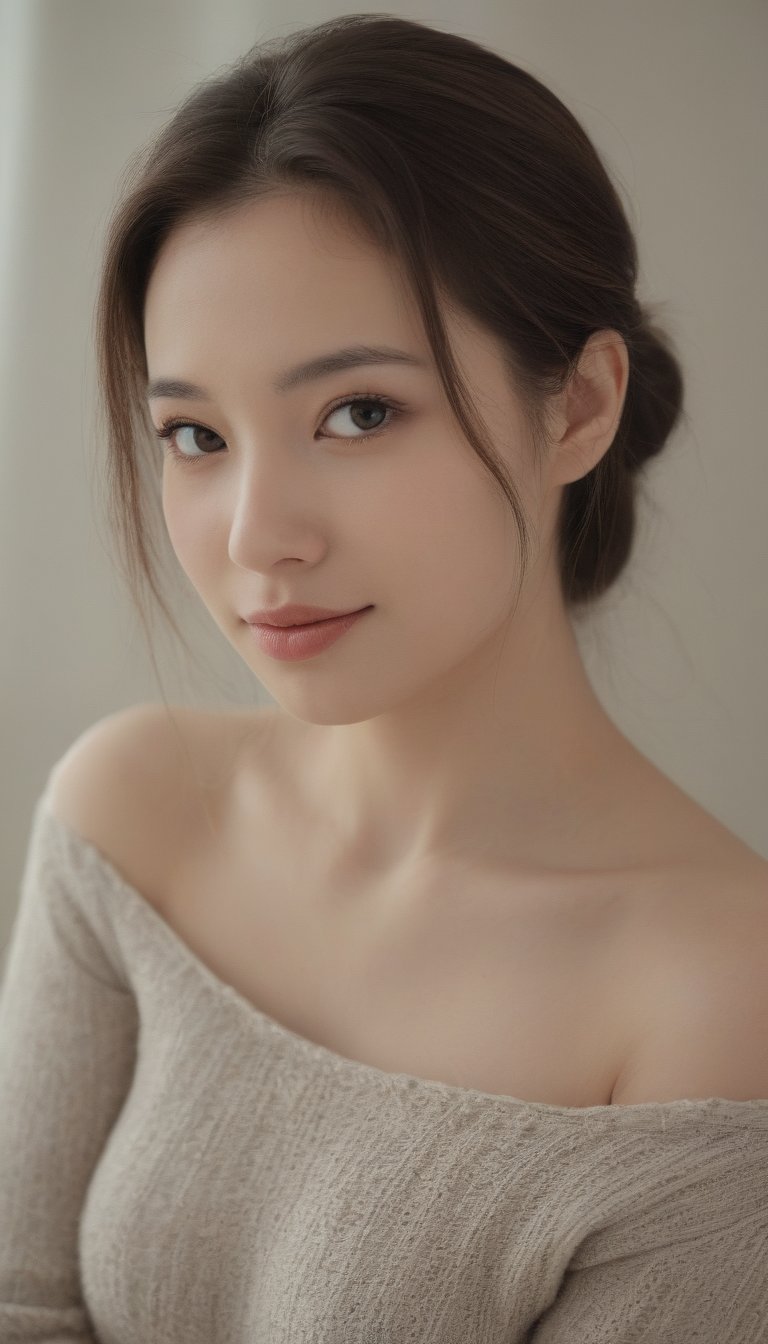
差异一目了然。RealVisXL 出的是「生活抓拍」:淡妆近素颜,窗景入画,像家人随手拍的照片。Juggernaut 出的是「商业写真」:妆容完整,轮廓光明显,背景全部虚化突出人物,提示词的每个细节(一字肩、姿态、发丝光)都执行到位。
还有一个容易忽略的指标:提示词服从性。我写了「微微露肩」,Juggernaut 精准执行,RealVisXL 直接画成了圆领毛衣。对商业交付来说,模型听不听话,比单看画质更重要。
所以最终选型比「谁画质高」更立体:
- 主力 Juggernaut:精致感、服从性、可控性全占,商品图和人像商单的交付主力
- 辅助 RealVisXL:客户要「真实自然、不像 AI」的生活感照片时,它反而占优
- 两个互补,都不删
小结
底模决定画质上限,效果不好先查底模,再动提示词。按业务方向选专精模型,弃多面手;下载认准 CivitAI 与 HuggingFace,选 fp16、BakedVAE、Lightning 版。
现在就把底模装进 ComfyUI,用固定 seed 跑一组自己的对照图——亲眼看过一次,胜过读十篇选型文。下一篇进入参数篇:CFG、步数、采样器,每调一个参数看一张对比图。